Laboratorio 02
Primo Programma C++: Discesa del Gradiente e Backpropagation
Soluzione del Laboratorio 01: il CMakeLists.txt
CMakeLists.txt
cmake_minimum_required(VERSION 3.15)
project(BasicNeuralPlusPlus)

set(CMAKE_CXX_STANDARD 17)
set(CMAKE_CXX_STANDARD_REQUIRED ON)
set(CMAKE_CXX_FLAGS "${CMAKE_CXX_FLAGS} -Wall")

find_package(Eigen3 QUIET)
find_package(OpenCV REQUIRED)
message(STATUS "OpenCV ${OpenCV_VERSION} trovata")

add_executable(basic_neural main.cpp)

if(Eigen3_FOUND)
1    target_link_libraries(basic_neural Eigen3::Eigen)
else()
    message(STATUS "Eigen non trovata: uso libs/eigen")
    target_include_directories(basic_neural PRIVATE libs/eigen)
endif()
target_link_libraries(basic_neural ${OpenCV_LIBS})- 1
-
È la riga che quasi tutti dimenticano. Trovare Eigen con
find_packagenon basta: senza questa, la compilazione muore confatal error: Eigen/Dense: No such file or directoryanche con Eigen installata.
Soluzione del Laboratorio 01: il main.cpp
main.cpp
#include <cstdlib>   // std::srand
#include <ctime>     // std::time
#include <iostream>
#include <Eigen/Dense>
#include <opencv2/opencv.hpp>

int main() {
1    // std::srand(std::time(nullptr));
    Eigen::MatrixXf W = Eigen::MatrixXf::Random(3, 4);
    Eigen::VectorXf x = Eigen::VectorXf::Random(4);

    Eigen::VectorXf z = W * x;
    std::cout << "z e' " << z.rows() << "x" << z.cols() << ":\n" << z << "\n\n";

2    Eigen::ArrayXf z_relu = z.array().max(0.0f);
    std::cout << "dopo la ReLU:\n" << z_relu << "\n\n";
// ... segue l'immagine OpenCV- 1
-
Random()usastd::rand(): senza un seme la sequenza è sempre la stessa. Togliendo il commento i numeri cambiano a ogni esecuzione.nullptrè ilNULLdel C++ (Lezione 05). - 2
- Il vostro primo forward pass: un prodotto matrice-vettore e una non linearità. È tutto quello che fa uno strato.
Soluzione del Laboratorio 01: il main.cpp (segue)
main.cpp
    cv::Mat img(28, 28, CV_8UC1, cv::Scalar(128));
    std::cout << "immagine " << img.rows << "x" << img.cols
              << ", canali: " << img.channels() << "\n";

1    cv::imwrite("test.png", img);
    cv::imshow("Test MNIST size", img);
2    while (cv::waitKey(100) < 0 &&
           cv::getWindowProperty("Test MNIST size", cv::WND_PROP_VISIBLE) >= 1) {}
}- 1
-
Prima
imwrite: funziona anche senza finestre grafiche, quindi il PNG c’è anche doveimshowfallisce. - 2
-
waitKey(0)aspetterebbe solo un tasto: chiudendo la finestra col mouse il programma resterebbe in attesa. Così esce in entrambi i casi. È lo stesso ciclo didisplay()nel framework.
Soluzione del Laboratorio 01: cosa stampa
z e' 3x1:
  -1.0027
0.0832618
-0.192788

dopo la ReLU:
        0
0.0832618
        0

immagine 28x28, canali: 1
I vostri numeri possono essere diversi da questi, perché std::rand() cambia da un sistema all’altro, ma a ogni esecuzione saranno gli stessi finché non date un seme con std::srand. La forma invece no: z deve essere \(3 \times 1\), e dopo la ReLU i negativi devono essere esattamente 0 e i positivi invariati. Se le dimensioni non tornano, avete invertito W e x.
Obiettivo di oggi
Il progetto del Laboratorio 01 compila: oggi lo usiamo per il primo programma C++ vero, con quello che avete visto nelle Lezioni 03 e 04.
- Ripartire dal progetto del Laboratorio 01.
- Tipi base e divisione intera: il primo errore silenzioso del calcolo scientifico.
- Il quesito 1 della Lezione 03 al calcolatore: la discesa del gradiente su \(E(x) = x^2\).
- L’esercizio in classe della Lezione 03 in C++: forward, backward e gradient check.
- Addestrare la catena di due neuroni con un ciclo
for.
Bastano double, std::exp, for, if e std::cout. Le funzioni le conoscete dal C, e in C++ le riprendiamo nella Lezione 05: oggi, apposta, tutto sta nel main().
Task 1: ripartire dal Laboratorio 01
- Verificate che compilatore e CMake rispondano:
g++ --version(Linux e WSL) oclang++ --version(macOS), ecmake --version. Se uno non risponde, le istruzioni sono nel Laboratorio 01. - Aprite nel vostro IDE la cartella del Laboratorio 01,
basic_neural_plusplus: da qui in avanti è il progetto del framework. Il suoCMakeLists.txtcresce, non si riscrive. - Sostituite il
main.cppcon uno che stampi “Inizio progetto BASIC_NEURAL++!” e compilate da zero:
oppure con i pulsanti di CMake Tools in VS Code. Eigen e OpenCV oggi non servono, ma un solo file di build evita di ritrovarsi con due progetti diversi.
Task 2: tipi base e divisione intera
Nel main.cpp dichiarate, stampate e combinate:
- un
int(per esempio il numero di epoche) e undouble(il learning rate); 5 / 2fra dueint: cosa stampa, e perché? (come in C; Lezione 04)- la stessa divisione con
static_cast<double>(a) / b.
Task 3: il quesito 1 al calcolatore
Il quesito 1 della Lezione 03: loss \(E(x) = x^2\), partenza \(x_0 = 1\), passo \(x \leftarrow x - \eta\,E'(x)\) con \(E'(x) = 2x\). Per quali \(\eta\) il metodo converge, e quale centra il minimo in un solo passo?
- Scrivete un ciclo
forche faccia cinque passi e stampi \(x\) dopo ognuno. - Mettetelo dentro un secondo ciclo che provi \(\eta = 0{,}25,\ 0{,}5,\ 0{,}75,\ 1,\ 1{,}25\):
- Per ogni \(\eta\): la discesa converge, centra il minimo, oscilla o diverge? Confrontate con la risposta del quesito.
Il contatore è un int e \(\eta\) si ricava da lui: un ciclo for (double eta = 0.1; ...; eta += 0.1) accumulerebbe errori di arrotondamento, perché \(0{,}1\) non è rappresentabile esattamente in binario.
Task 4: la catena di due neuroni
L’esercizio in classe della Lezione 03: due neuroni sigmoidi in fila, senza bias.
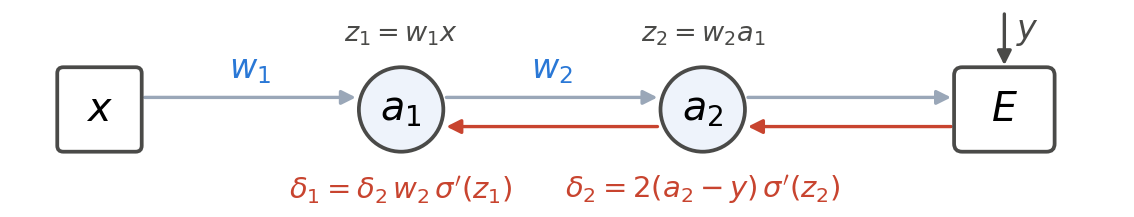
\[ x \;\to\; z_1 = w_1 x \;\to\; a_1 = \sigma(z_1) \;\to\; z_2 = w_2 a_1 \;\to\; a_2 = \sigma(z_2), \qquad E = (a_2 - y)^2 \]
con \(\sigma(z) = 1/(1 + e^{-z})\) e \(\sigma'(z) = \sigma(z)\,\big(1 - \sigma(z)\big)\). La backpropagation dà
\[ \delta_2 = 2(a_2 - y)\,\sigma'(z_2), \quad \delta_1 = w_2\,\delta_2\,\sigma'(z_1), \quad \frac{\partial E}{\partial w_2} = \delta_2\, a_1, \quad \frac{\partial E}{\partial w_1} = \delta_1\, x . \]
Con \(x = 1\), \(w_1 = w_2 = 1\), \(y = 1\) dovete ritrovare \(E = 0{,}1056\) e \(\partial E/\partial w_1 = -0{,}0280\).
Task 4: in C++
Con \(x = 1\), \(w_1 = w_2 = 1\), \(y = 1\):
- Forward: una variabile
doubleper ciascuna di \(z_1, a_1, z_2, a_2\) ed \(E\). La sigmoide è1.0 / (1.0 + std::exp(-z)), con#include <cmath>. - Backward: \(\sigma'(z) = a\,(1-a)\), poi \(\delta_2\), \(\delta_1\), \(\partial E/\partial w_2 = \delta_2\, a_1\) e \(\partial E/\partial w_1 = \delta_1\, x\).
- Stampate una tabella (una riga per grandezza, una colonna per strato, colonne separate da
"\t") e confrontatela con la soluzione nella Lezione 03. - Gradient check: ricalcolate \(E\) con \(w_1 + h\) e con \(w_1 - h\), \(h = 0{,}01\), e confrontate \(\big[E(w_1+h) - E(w_1-h)\big]/2h\) con \(\partial E/\partial w_1\).
Il forward va ricopiato due volte: è scomodo, ed è voluto. Nel Laboratorio 03 lo risolveremo con una funzione, double sigmoid(double z).
Task 5: addestrare la catena
Ora i pesi si aggiornano: discesa del gradiente su \(w_1\) e \(w_2\), con un solo esempio e \(\eta = 1\):
I due gradienti vanno calcolati entrambi prima di aggiornare i pesi, nello stesso punto (Lezione 03): aggiornare w2 e poi calcolare delta1 con il w2 nuovo è un errore silenzioso. A \(t = 0\) deve uscire \(E = 0{,}1056\), come nel Task 4.
- \(E\) scende? Di quanto, in 200 passi?
- Guardate i pesi: si fermano?
- Rifate tutto con \(y = 0{,}8\). Cosa cambia, e perché? Un suggerimento: per quale \(z\) la sigmoide vale 1?
Task da completare
Buon lavoro! La soluzione di riferimento verrà discussa all’inizio del prossimo laboratorio.