Approfondimento facoltativo: la matematica delle reti convoluzionali
Cristiano De Michele
Un filtro su più canali
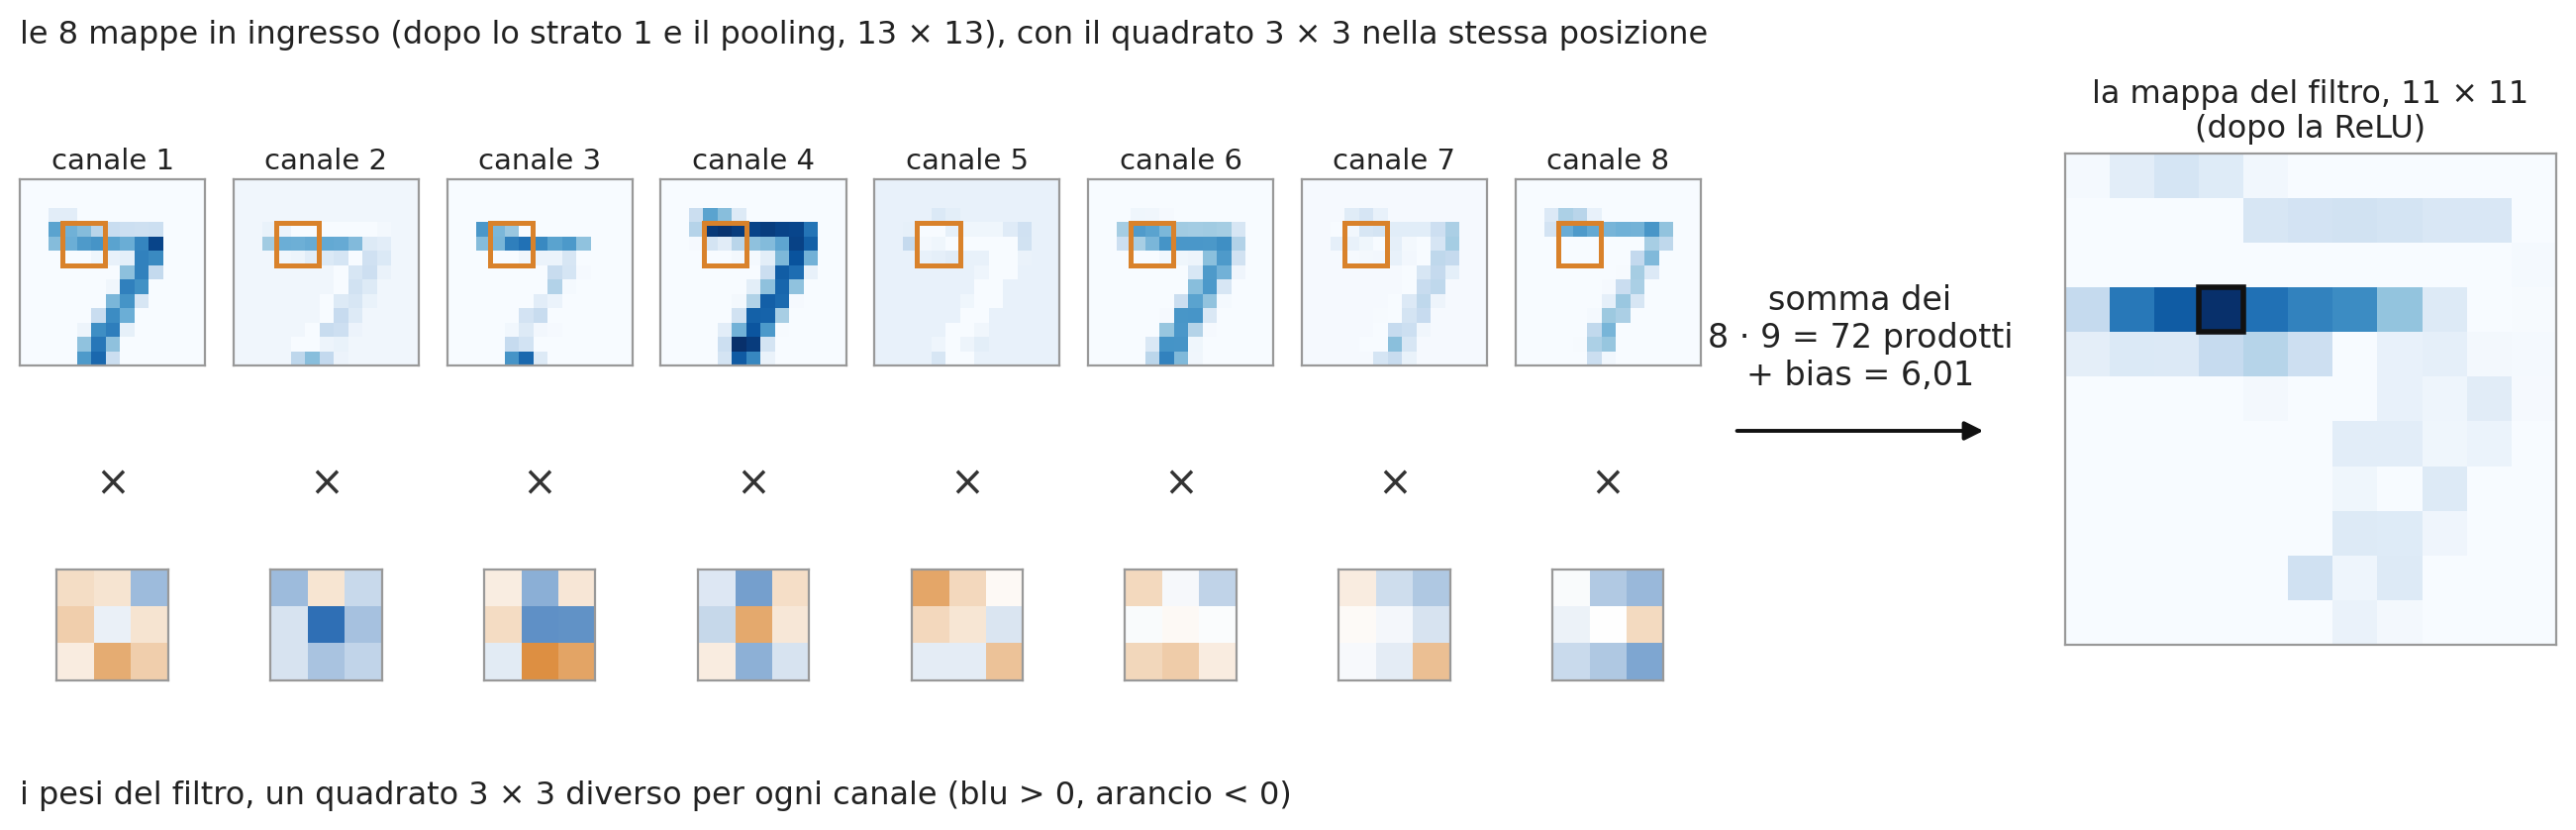
Un filtro dello strato 2 ha un quadrato di 3 × 3 pesi per ogni canale in ingresso, diverso da canale a canale. In ogni posizione somma i prodotti su tutti i canali, più un bias: \[z^{(k)}_{ij} = \sum_{c=1}^{C} \sum_{p=0}^{2} \sum_{q=0}^{2} w^{(k,c)}_{pq}\, x^{(c)}_{i+p,\, j+q} + b^{(k)}\] dove \(k\) è il filtro e \(c\) il canale. Questo filtro, dopo l’addestramento, risponde alla barra orizzontale del 7.
Perché mescolare i canali
Una forma si riconosce dalla combinazione di elementi diversi nello stesso posto: nell’angolo del 7 la barra orizzontale incontra il tratto obliquo.
Se dopo lo strato 1 il canale A vale 1 sui tratti orizzontali e il canale B su quelli obliqui, un filtro con peso +1 sull’orizzontale in A, +1 sull’obliquo in B e bias −1,5 dà:
c’è
somma
dopo la ReLU
solo l’orizzontale
1 − 1,5 = −0,5
0
solo l’obliquo
1 − 1,5 = −0,5
0
tutti e due
2 − 1,5 = 0,5
0,5
La somma sui canali, il bias e la ReLU fanno un «e»: il filtro risponde solo dove i due elementi si incontrano, e un filtro su un canale solo non potrebbe. Allo stesso modo, in un MLP ogni neurone del secondo DenseLayer legge tutte le uscite del primo.
Quanti filtri
Il numero di filtri di uno strato si sceglie, come il numero di neuroni di un DenseLayer. Ogni filtro produce una mappa, quindi i canali in uscita sono tanti quanti i filtri; i canali in ingresso, le mappe dello strato precedente, fissano invece quanti quadrati di pesi ha ogni filtro: uno per canale, \(C \times K \times K\) pesi in tutto.
Uno strato con \(F\) filtri \(K \times K\) su \(C\) canali ha \[F\,(C K^2 + 1)\] parametri: \(8\,(1 \cdot 9 + 1) = 80\) nello strato 1, \(16\,(8 \cdot 9 + 1) = 1168\) nello strato 2.
Di solito i canali crescono mentre le mappe si rimpiccioliscono: dopo lo strato 1 ci sono 8 × 26 × 26 = 5408 valori, dopo lo strato 2 sono 16 × 11 × 11 = 1936. Più domande, su zone più grandi, in meno posizioni.
Il bordo: il padding
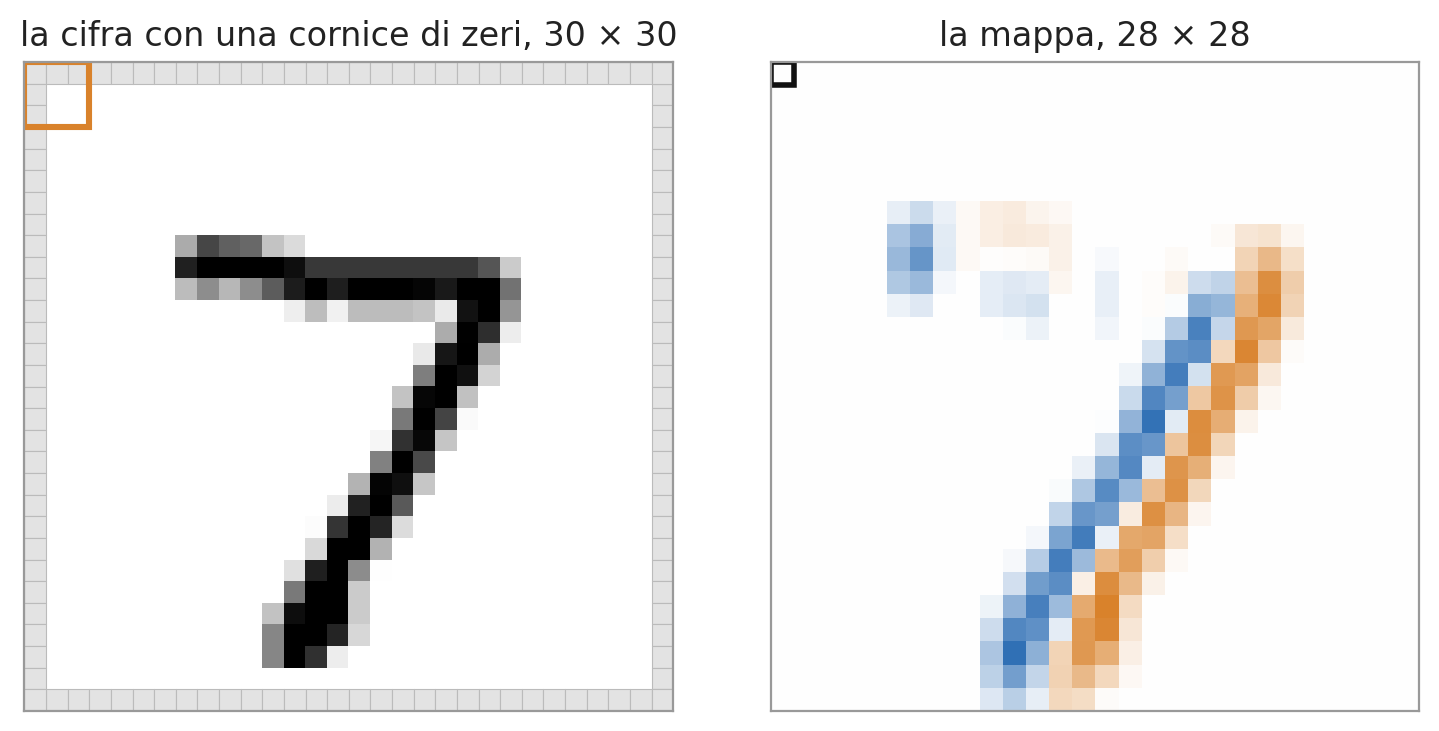
Senza padding un filtro 3 × 3 non si può centrare sui pixel del bordo, e ogni strato toglie una riga e una colonna per lato: 28 → 26 → … Il padding aggiunge intorno all’immagine una cornice di zeri larga \(P\): con \(P = 1\) il filtro si centra anche sul pixel in alto a sinistra, e la mappa resta 28 × 28. Gli zeri non aggiungono niente alla somma: sul bordo il filtro usa solo i pixel che ci sono.
Lo stride
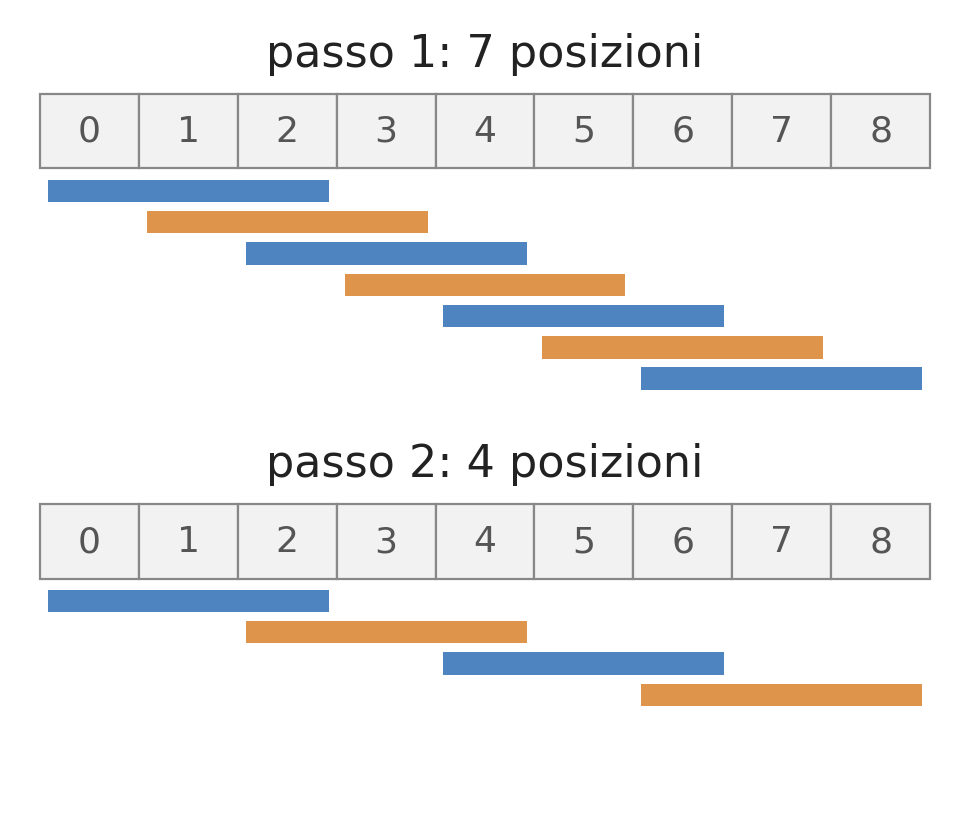
Lo stride\(S\) è il passo del filtro: con \(S = 2\) salta una posizione ogni due, e la mappa ha circa metà righe e metà colonne. È un altro modo di rimpicciolire le mappe, al posto del pooling.
Con \(N\) pixel per lato, filtro \(K \times K\), padding \(P\) e stride \(S\), la mappa ha per lato \[N_{out} = \left\lfloor \frac{N + 2P - K}{S} \right\rfloor + 1\] Strato 1: \((28 - 3)/1 + 1 = 26\). Anche il max pooling 2 × 2 segue la formula, con \(K = S = 2\): \(\lfloor 24/2 \rfloor + 1 = 13\) e \(\lfloor 9/2 \rfloor + 1 = 5\).
Fin dove vede un filtro
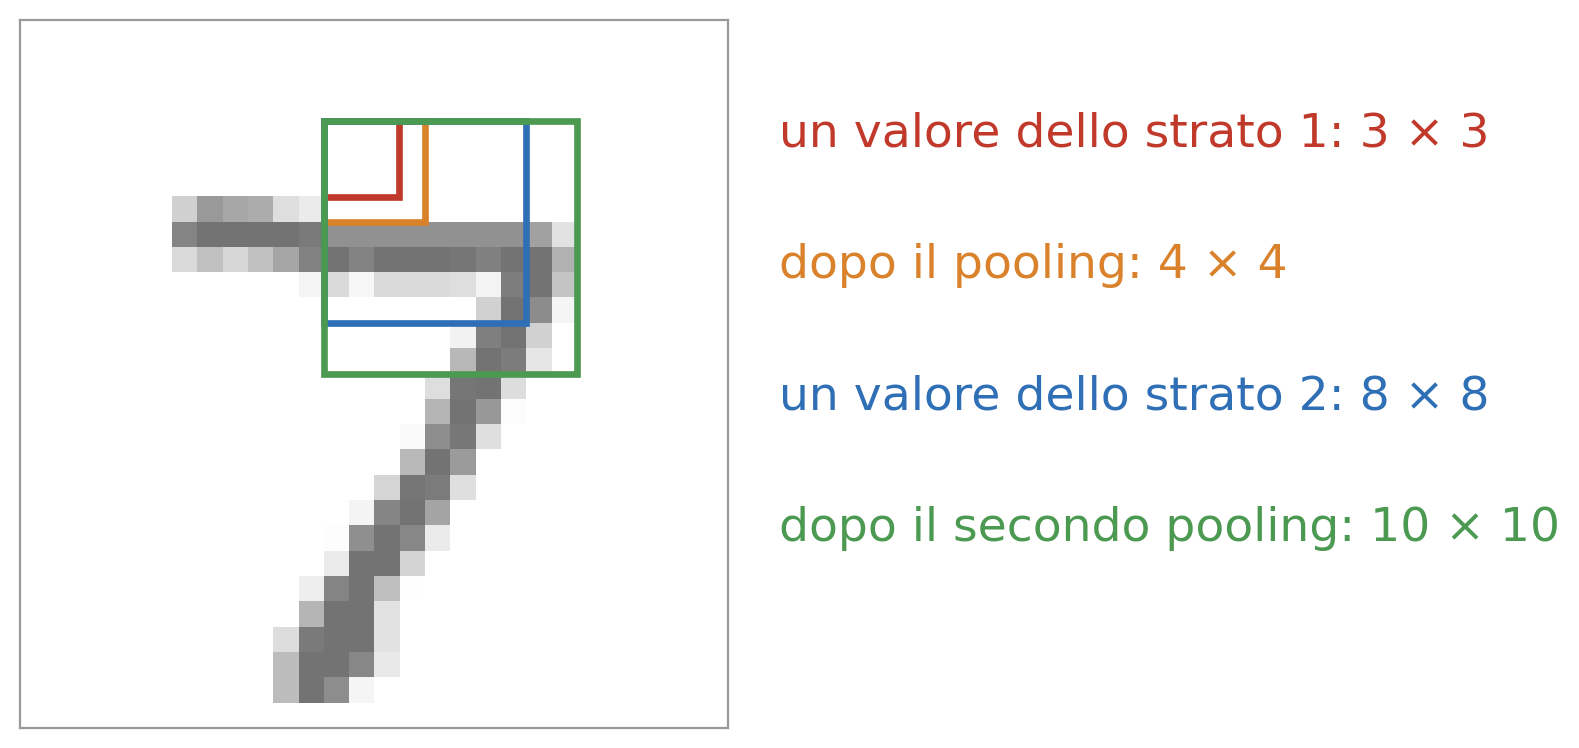
Il campo recettivo di un valore è la zona della cifra da cui dipende. Un valore dello strato 1 dipende da 3 × 3 pixel; il massimo di due valori vicini da 4 × 4, perché i loro quadrati si sovrappongono; un filtro dello strato 2, su 3 × 3 valori della mappa dimezzata, da 8 × 8; dopo il secondo pooling, da 10 × 10.
Due filtri 3 × 3 di fila, senza pooling, vedono 5 × 5 pixel come un filtro 5 × 5, ma con 2 · 9 = 18 pesi invece di 25 per coppia di canali, e una ReLU in più in mezzo.
Perché non un pooling 8 × 8
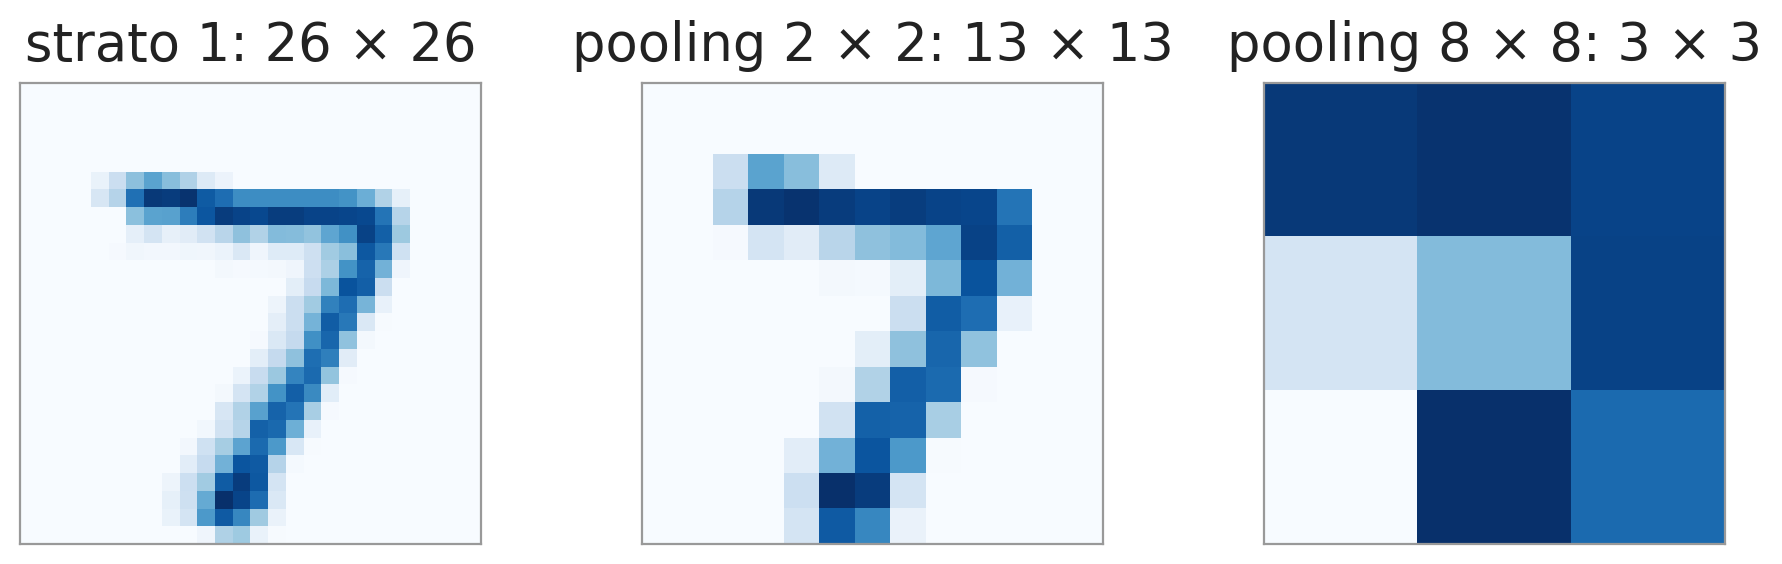
Con un pooling 8 × 8 la mappa passa da 26 × 26 a 3 × 3: ogni valore dice solo che in una zona di 8 × 8 pixel c’è un tratto, non dove né accanto a cosa. Nelle stesse condizioni:
rete
parametri
sul test
1 strato, 8 filtri, pooling 8 × 8
810
95,0%
1 strato, 64 filtri, pooling 8 × 8
6410
97,6%
1 strato, 8 filtri, pooling 2 × 2
13 610
97,9%
2 strati, «Dai bordi alle cifre»
5258
98,4-98,6%
La backpropagation di un filtro
Come nella Lezione 03, \(\delta_{ij} = \partial E / \partial z_{ij}\) è il segnale d’errore della posizione \((i, j)\) della mappa. Da \(z_{ij} = \sum_{p,q} w_{pq}\, x_{i+p,\, j+q} + b\): \[\frac{\partial E}{\partial w_{pq}} = \sum_{i,j} \delta_{ij}\, x_{i+p,\, j+q} \qquad\qquad \frac{\partial E}{\partial b} = \sum_{i,j} \delta_{ij}\] Il peso è lo stesso in tutte le posizioni, e il suo gradiente somma i contributi di tutte: come per un peso di un DenseLayer si sommano quelli degli esempi di un batch.
Verso l’ingresso, ogni pixel entra in 9 posizioni del filtro (meno sul bordo): \[\frac{\partial E}{\partial x_{mn}} = \sum_{p,q} \delta_{m-p,\, n-q}\, w_{pq}\] con \(\delta = 0\) fuori dalla mappa. Con più canali si somma anche sui filtri \(k\), con i pesi \(w^{(k,c)}_{pq}\).
La backpropagation del max pooling
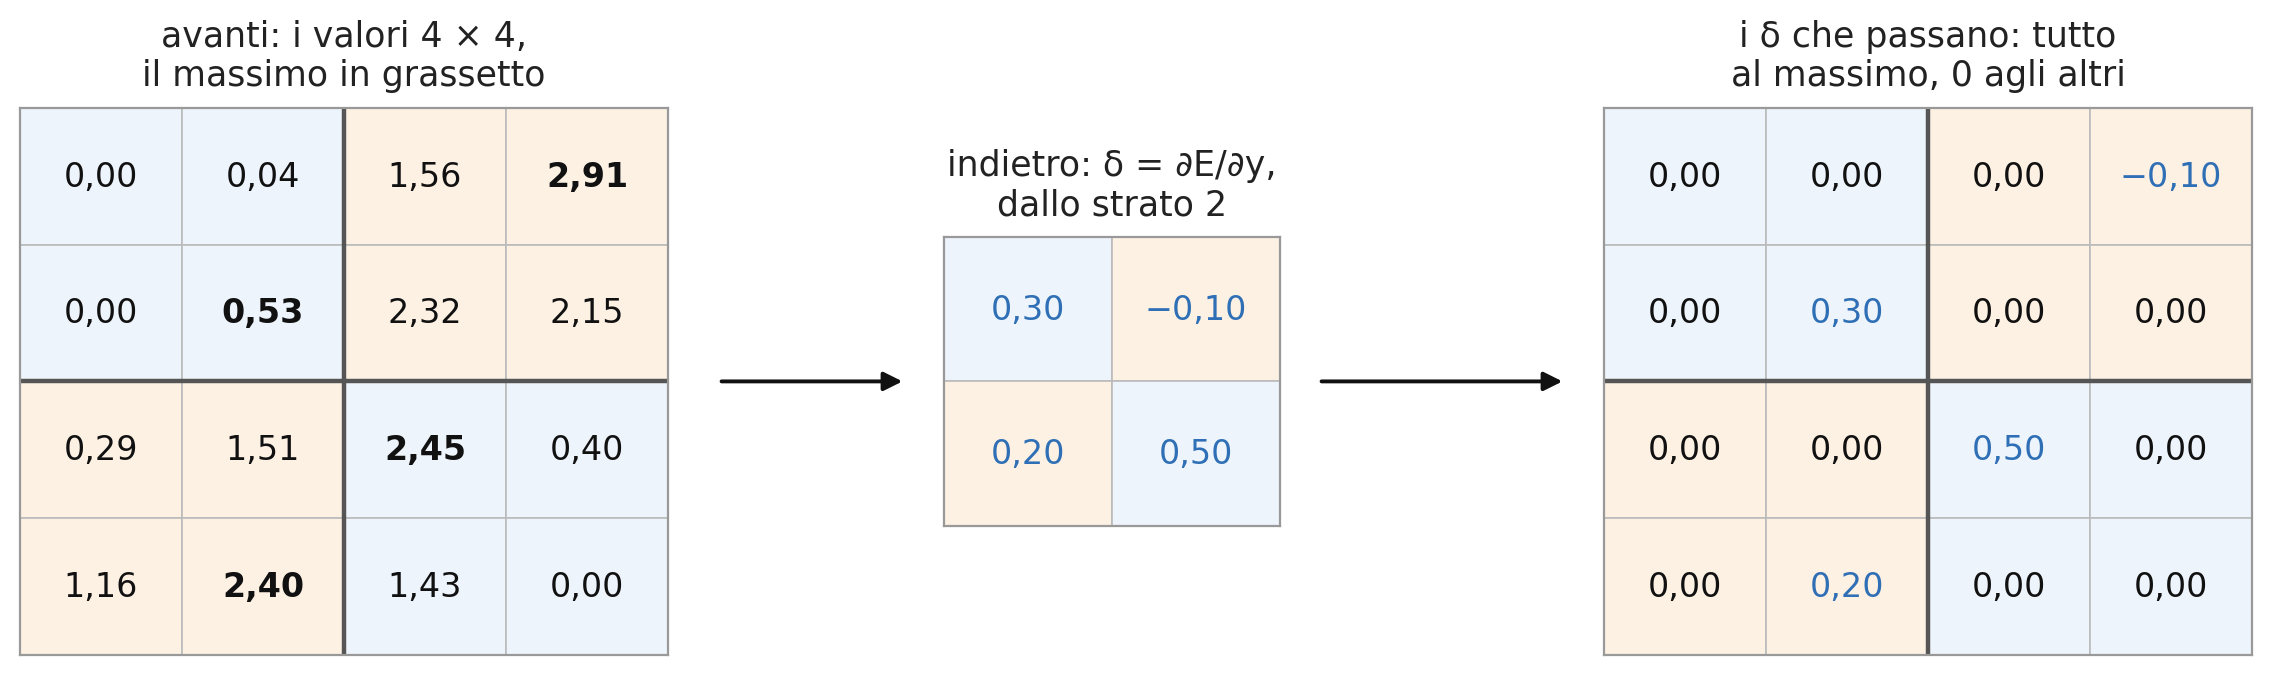
Il pooling calcola \(y = \max(a_1, a_2, a_3, a_4)\) per ogni quadrato. Nel quadrato in alto a destra \(y = 2{,}91\): se 2,91 cresce di 0,01, \(y\) cresce di 0,01; se cresce 2,32, \(y\) non cambia. Quindi \[\frac{\partial y}{\partial a_j} = \begin{cases} 1 & \text{se } a_j \text{ è il massimo} \\ 0 & \text{altrimenti} \end{cases} \qquad\qquad \frac{\partial E}{\partial a_j} = \delta \, \frac{\partial y}{\partial a_j}\] dove \(\delta = \partial E / \partial y\) arriva dallo strato successivo. Il \(\delta\) va tutto al massimo e gli altri tre ricevono 0; per questo nel passo in avanti si ricorda dove stava il massimo. Il pooling non ha pesi da aggiornare.
Convoluzione o correlazione?
In matematica la convoluzione di \(x\) con \(w\) capovolge il filtro: \[(w * x)_{ij} = \sum_{p,q} w_{pq}\, x_{i-p,\, j-q}\] Quello che calcola uno strato di una CNN, con \(x_{i+p,\, j+q}\), è una correlazione: una convoluzione con il filtro ruotato di 180°. Molte librerie calcolano la correlazione e la chiamano convoluzione.
Per una rete non cambia niente: i pesi si imparano, e la rete impara direttamente il filtro ruotato. La convoluzione vera compare comunque: il gradiente verso l’ingresso, nella slide «La backpropagation di un filtro», è la convoluzione dei \(\delta\) con il filtro.
Un filtro in C++
Il filtro dei bordi verticali della Lezione 15, con Eigen, sul 7 di mnist_test.csv.
filtro.cpp (prima parte)
#include <fstream>#include <iostream>#include <stdexcept>#include <string>#include <Eigen/Dense>// la prima cifra di mnist_test.csv: 28 x 28, fra 0 e 1Eigen::MatrixXd prima_immagine(conststd::string& nome){std::ifstream f(nome);if(!f)throwstd::runtime_error("non trovo "+ nome);std::string intestazione;std::getline(f, intestazione);int etichetta;char virgola; f >> etichetta; Eigen::MatrixXd x(28,28);for(int i =0; i <28;++i)for(int j =0; j <28;++j){ f >> virgola >> x(i, j); x(i, j)/=255.0;}return x;}
A mano:\(z_{15,14}\) è la colonna di destra del quadrato meno quella di sinistra, \((0{,}52 + 0{,}80 + 1{,}00) - (0 + 0 + 0) = 2{,}32\): il valore della slide 4 della Lezione 15.
La mappa è quella della slide 4, in caratteri: + dove il tratto comincia, andando verso destra, - dove finisce.
Provate: alla riga 39 mettete il filtro dei bordi orizzontali, -1, -1, -1, 0, 0, 0, 1, 1, 1. Cosa cambia?
Si accende la barra del 7: + sopra, dove il tratto comincia andando verso il basso, - sotto. L’obliquo resta, perché scende anche in verticale. z(15, 14) diventa 0.968627.
Quanto costa
Le moltiplicazioni per un’immagine, una per peso e per posizione (le somme sono altrettante):
strato
conto
moltiplicazioni
1
26 × 26 posizioni × 8 filtri × 9 pesi
48 672
2
11 × 11 posizioni × 16 filtri × 72 pesi
139 392
3
DenseLayer(10, 400)
4000
totale
192 064
La rete 784 → 128 → 10 ne fa \(784 \cdot 128 + 128 \cdot 10 = 101\,632\). La CNN ha 19 volte meno parametri ma fa quasi il doppio dei calcoli, perché ogni peso si usa in molte posizioni. Il conto cresce con l’area dell’immagine: per questo le CNN si eseguono sulle GPU.
Dalle cifre a ImageNet
LeNet-5 (LeCun e altri, 1998): due strati di filtri 5 × 5 (6 e 16) con sottocampionamento 2 × 2, poi strati densi; leggeva gli assegni. La nostra rete è una sua miniatura.
AlexNet (Krizhevsky, Sutskever e Hinton, 2012): 5 strati di filtri e 3 densi, 60 milioni di parametri, due GPU. Su ImageNet (1000 classi) la risposta giusta manca fra le sue prime 5 nel 15,3% dei casi, contro il 26,2% del secondo.
VGG (Simonyan e Zisserman, 2014): solo filtri 3 × 3, fino a 19 strati e 144 milioni di parametri.
ResNet (He e altri, 2015): fino a 152 strati, con le connessioni residue\(\mathbf{y} = F(\mathbf{x}) + \mathbf{x}\), che lasciano passare il gradiente; 3,57% sullo stesso test.
ViT (Dosovitskiy e altri, 2020): un transformer sui quadrati 16 × 16 dell’immagine, senza filtri. Non sa che i pixel vicini contano insieme: con i soli dati di ImageNet resta sotto le ResNet, con molti più dati le supera.
Per saperne di più
Y. LeCun, L. Bottou, Y. Bengio, P. Haffner, «Gradient-based learning applied to document recognition», Proceedings of the IEEE 86 (1998): l’articolo di LeNet-5, con il confronto fra le reti sulle cifre.
I. Goodfellow, Y. Bengio, A. Courville, Deep Learning, MIT Press 2016, capitolo 9 (gratuito su deeplearningbook.org).
V. Dumoulin, F. Visin, «A guide to convolution arithmetic for deep learning» (2016, arXiv:1603.07285): padding, stride e dimensioni delle mappe, con molte figure.